Gradle daemon 在构建结束后持续占用内存带宽的问题分析
在 fabric-mod-template 里增删子项目或改动子项目的 Minecraft 版本后,
有时只跑一次 gradlew,命令结束后整机的内存读取带宽仍稳定在 29 GB/s 左右,写入带宽约 26 GB/s。
停掉 Gradle daemon 后,带宽随即回落。多台 Windows 开发机上都出现过这个现象
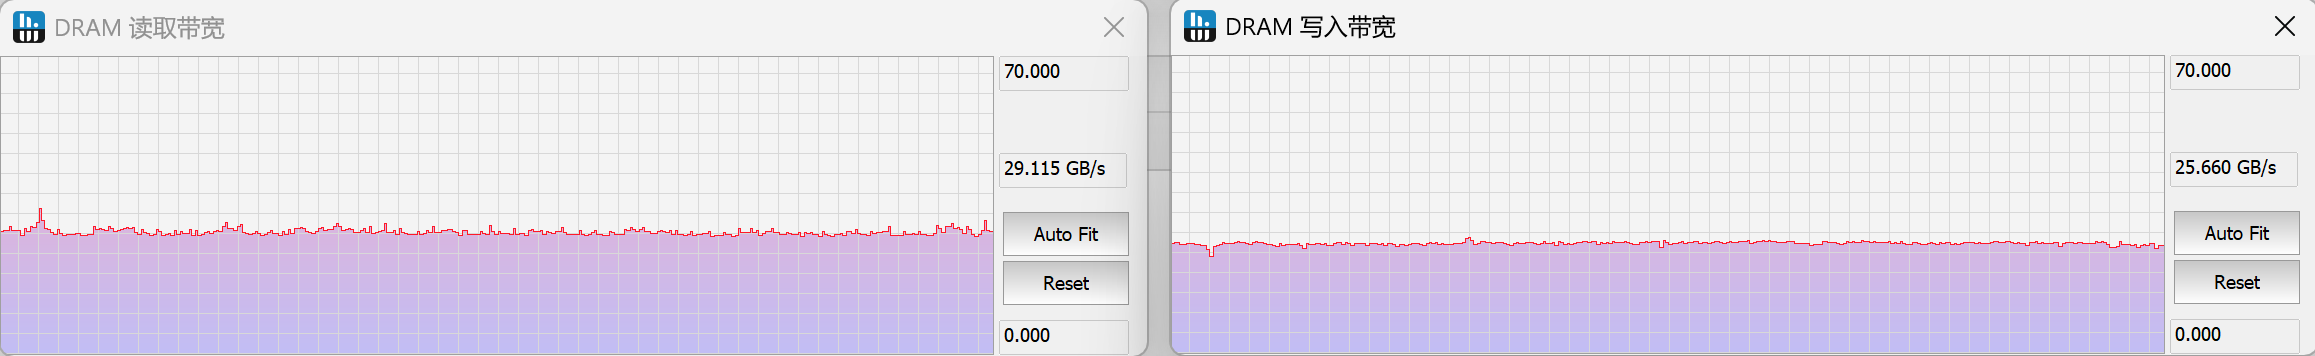
省流:旧版 Xray 的 Vision 在连接关闭时多送了一条 TLS 记录, 让 Fabric Loom 所用的 JDK HttpClient 陷入一个不断分配缓冲区的死循环。升级 JDK 或升级 Xray 服务端均可解决
环境
- Windows,多台开发机均可复现
- Gradle 9.8.2,daemon 运行在 Oracle JDK 25.0.2 上
- Fabric Loom 1.19.3
- 经本机 Xray 客户端提供的 HTTP 代理上网,节点使用 VLESS +
xtls-rprx-vision。Xray 客户端 26.10.21,服务端 26.3.27
分析
分配热点
先用 jcmd 找到出问题的 Gradle daemon,隔几十秒抓两次带扩展信息的线程栈,再录一段 20 秒的 Java Flight Recorder(JFR)。
JFR 是 JDK 自带的低开销采样工具,可以记录对象分配、GC 等事件,正适合查“谁在吃内存带宽”
1 | jcmd -l |
两次线程栈相隔约 36 秒,其中一个工作线程 ForkJoinPool-1-worker-2 的 CPU 时间涨了约 35 秒,基本占满了一个核心。
Java 的虚拟线程不独占系统线程,而是挂在 ForkJoinPool 的工作线程上运行。
两次采样时,这个工作线程上跑的都是同一个虚拟线程,执行的是 JDK HttpClient 的 TLS 读取代码
JFR 的结果更直接:这个线程 20 秒内分配了 458 GiB 的对象,约合 23 GiB/s。
5,913 个对象分配样本里,有 5,909 个是这个虚拟线程沿同一条调用路径分配的 byte[]
1 | SSLFlowDelegate.Reader.processData |
SSLFlowDelegate 是 JDK HttpClient 内部负责 TLS 收发的组件,
其中的 Reader 把从 socket 读到的密文交给 TLS 引擎 SSLEngine 解密,这一步叫 unwrap。
getAppBuffer() 为每次 unwrap 申请一块存放明文的输出缓冲区
这些缓冲区刚分配就被丢弃,20 秒内 G1 做了 194 次年轻代 GC 来回收它们。 所以进程的内存占用只有几 GiB,持续的分配和清零却把内存带宽吃满了
请求来源
线程栈里只有 JDK 内部的异步任务,看不出是谁发起了这个 HTTPS 请求。
于是用 jcmd 18472 GC.heap_dump -all heap.hprof 导出一份堆快照,
从这个 Reader 沿对象引用往回找到它所属的 HttpClientImpl,再找持有这个客户端的对象,
最终指向 Fabric Loom 1.19.3 下载器里的静态字段 net.fabricmc.loom.util.download.Download.HTTP_CLIENT
这条连接的目标是 piston-data.mojang.com,也就是 Loom 下载 Minecraft 资源用的服务器(下称资源服务器)。
连接经本机 HTTP 代理以 CONNECT 方式建立:代理只负责在两端之间转发字节,TLS 加密仍在 Java 与资源服务器之间端到端进行。
协商的协议为 HTTP/2 和 TLS 1.3
这也解释了为什么只跑 gradlew 就能触发。Gradle 在配置项目时会执行各子项目的构建脚本,
Loom 在这一阶段就会按脚本声明的 MC 版本准备依赖。版本改动后,本地缺的资源会在这时下载。
Gradle daemon 在命令结束后继续存活,这次下载留下的 HttpClient 后台任务也就一直留在 daemon 里
停不下来的读取循环
堆快照里还保存着这条连接的关闭状态。先说明其中涉及的两个关闭信号
GOAWAY是 HTTP/2 的帧,表示对端不再接受新请求,准备关闭连接close_notify是 TLS 层的关闭通知,以一条告警(alert)记录的形式发送。 TLS 引擎收到它之后就关闭输入方向,此后的 unwrap 一律返回CLOSED,不再消费任何输入
Reader 还维护着自己的完成标记 completing。只有上游,也就是 socket 一侧通知数据流结束后,它才会变为 true。
数据流结束指 socket 读到 EOF,即对端关闭了 TCP 连接
| 对象 | 字段 | 现场值 |
|---|---|---|
| HTTP/2 连接 | 是否收到 GOAWAY、活动请求数 |
已收到,0 |
| TLS 引擎 | 是否收到 close_notify、最近一次 unwrap 的结果 |
已收到,CLOSED |
Reader |
输入缓冲区 readBuf 的 position / limit |
0 / 24 |
Reader |
minBytesRequired |
0 |
Reader |
completing |
false |
SSLFlowDelegate |
每次申请的输出缓冲区大小 | 16384 |
从 HTTP/2 和 TLS 两层看,这条连接都已经结束了,但 Reader 的输入缓冲区里还剩 24 字节没处理,
socket 也还没读到 EOF。JDK 25.0.2 中 Reader.processData() 的主循环简化后如下
1 | // 简化自 JDK 25.0.2 的 SSLFlowDelegate.Reader.processData() |
现场的状态恰好卡住了这段逻辑:TLS 引擎已经关闭,每次 unwrap 都不消费那 24 字节,循环条件 24 > 0 永远成立;
退出分支又要求 completing 为 true,而它始终是 false。
于是每一轮都白白申请一块 16 KiB 的缓冲区,这就是 JFR 里那条分配路径
(源码)
为了确认这个状态足以单独造成空转,我在独立的 JVM 里直接构造了它:关闭 SSLEngine,给尚未完成的 Reader 塞 24 字节,
不联网,也不涉及 Gradle 和 Loom。JDK 17.0.18、21.0.10、25.0.2 都在 500 毫秒内分配了 6 GiB 以上,调用栈与现场一致
接下来要弄清这 24 字节的来源:TLS 已经收到了 close_notify,对端本不该再发来任何数据
多出来的 24 字节
一个线索是,所有能复现问题的开发机都经 Xray 的 HTTP 代理上网。于是写了个单文件程序(见文末附录), 用 JDK HttpClient 和虚拟线程执行器(与 Loom 相同)从资源服务器下载一个约 4.5 MiB 的资源文件, 下载完成后继续持有客户端,观察连接关闭时发生了什么
复现需要让连接由资源服务器关闭。JDK HttpClient 默认会在 HTTP/2 连接空闲 30 秒后自己关掉它,那样就看不到对端的关闭过程。
实验里把 jdk.httpclient.keepalive.timeout 设为 120 秒,在下载结束约 90 秒后等到了资源服务器发来的 GOAWAY 和 close_notify
Gradle 现场走的是另一条时序。从堆中 HTTP/2 帧解码器的状态看,资源服务器的 GOAWAY 在最后一个响应传完之前就到了,
连接随最后一个请求结束直接进入关闭流程,没有经过 30 秒的空闲计时。两条时序最终落到了同一个 TLS 关闭过程上
同一个程序分别走三条网络路径。除了直连和 Xray,还加了一个自己写的普通 HTTP CONNECT 转发器,它只在两端之间原样复制字节, 用来区分“经过 HTTP 代理”和“经过 Xray”
| 网络路径 | 收到 close_notify 之后 |
下载结束后第 90–95 秒的 JVM 分配量 |
|---|---|---|
| 直连 | 读到 EOF,连接关闭 | 约 0.003 MiB |
| 普通 CONNECT 转发器 | 读到 EOF,连接关闭 | 约 0.003 MiB |
| Xray | 又收到 24 字节,开始空转 | 约 38 GiB |
三条路径都完整下载了文件,也都收到了 close_notify,区别只在之后:直连和普通转发器读到 EOF,Xray 路径则多出了 24 字节
为了看清这 24 字节到达的时机,我用 --patch-module 给测试 JVM 里的 SSLFlowDelegate 加了两处日志:
TLS_CLOSE_TRACE 记录 unwrap 返回 CLOSED 时输入缓冲区的变化,TLS_POST_CLOSE_INPUT 记录关闭之后上游又送来的数据。
before 和 after 是 unwrap 前后缓冲区的 position/limit。走 Xray 时,日志依次出现
1 | TLS_CLOSE_TRACE before=39/63 after=63/63 consumed=24 produced=0 |
第一行是资源服务器的 close_notify,它被完整消费,缓冲区读到了末尾。
第二行是之后上游单独送来的一段 24 字节新数据。第三行开始,TLS 引擎面对这段数据只返回 CLOSED,消费 0 字节,此后不断重复。
这正是 Gradle 现场堆里的状态
TLS 以记录为单位传输数据,每条记录以 5 字节的记录头开头,依次是内容类型、协议版本和长度。
这 24 字节的记录头是 17 03 03 00 13,表示一条后跟 19 字节密文的加密记录,
与前一条 close_notify 一样长,也与 TLS 1.3 下一条加密告警的大小相符。
也就是说,close_notify 之后,代理路径上又冒出了一条 TLS 告警
根因
Xray Vision 泄漏的外层关闭通知
VLESS 协议在 Xray 客户端和 Xray 服务端之间有自己的一层 TLS(下称外层 TLS), Java 与资源服务器之间的 HTTPS 则是被它承载的内层 TLS。 Vision 流控在识别出内层是 TLS 1.3 后会切换到 direct copy:两端绕过外层 TLS,直接在底层 TCP 连接上转发内层的字节, 省去一次加解密
旧版实现切换之后,外层 TLS 对象仍然留着。
连接收尾时,Xray 服务端照常关闭这个对象,它便往同一条 TCP 连接写出一条外层的加密 close_notify。
Xray 客户端此时正按 direct copy 原样转发字节,分不清这条记录不属于内层,于是把它交给了 Java。这就是那多出来的 24 字节
Xray 的 issue #6794 详细分析了这个问题,
复现中看到的同样是 17 03 03 00 13 加 19 字节。
修复 PR #6834 在切换到 direct copy 后抑制外层的关闭通知,
2026 年 9 月合并,首个包含它的版本是 26.9.30
本次的 Xray 客户端 26.10.21 已经包含修复,服务端 26.3.27 还没有。
这条记录由服务端写出,沿下行方向到达客户端,所以必须升级服务端。
服务端升级到 26.10.31 后,再用同一个程序经 Xray 下载,close_notify 之后直接读到 EOF,第 90–95 秒的分配量回到约 0.094 MiB
JDK HttpClient 的上游修复
TLS 1.3 规范(RFC 8446 §6.1)要求,收到关闭告警之后到达的数据一律忽略。 多数 TLS 实现照此处理,这条多余的记录通常无人察觉。JDK HttpClient 却会继续处理缓冲区里剩下的数据,进而卡进前面那个循环
JDK 已经修复了这个问题,对应 JDK-8374557 “Enhance TLS connection handling”。
补丁在 unwrapBuffer() 处理 CLOSED 的分支中加了两行
1 | case CLOSED: |
TLS 输入关闭后,剩余的输入被直接丢弃,Reader 进入完成状态,循环条件不再成立。补丁也一并调整了收到 close_notify 后的关闭流程。
该修复已进入 JDK 主线,并回移到 11.0.31、17.0.19、21.0.11、25.0.3 和 26.0.1,各分支的提交见文末参考。
本次现场的 25.0.2 不含这个修复。修复版 JDK 我没有在本机复测
故障链路
1 | Loom 在 Gradle 配置阶段经 Xray 代理下载 Minecraft 资源 |
- Xray 服务端是触发方。代理往内层字节流里混入了不属于它的数据,属于实现缺陷。Xray 26.9.30 已修复
- JDK HttpClient 是放大方。输入没有进展时既不退出也不报错,把一条多余的记录放大成了持续的分配,属于实现缺陷。 JDK 11.0.31、17.0.19、21.0.11、25.0.3、26.0.1 已修复
- Fabric Loom 和 Gradle daemon 是载体。Loom 在配置阶段发起下载,常驻的 daemon 让异常线程在构建结束后继续存在, 作为使用方,他俩都没有 bug
修好 Xray 或 JDK 中的任何一方,这条故障链路都会断开,也即不会遇到本篇文章描述的问题
影响范围
需同时满足下面三个条件。起始版本按上游源码推得,早期版本未经实测
| 组件 | 起始版本 | 修复版本 |
|---|---|---|
| Xray 服务端 | 1.6.2(2022 年 10 月) | 26.9.30 |
| JDK | 11(java.net.http 正式发布) |
11.0.31、17.0.19、21.0.11、25.0.3、26.0.1 |
| Fabric Loom | 0.13.1(2022 年 7 月) | 不涉及 |
- Xray 1.6.2 首次引入 Vision,初版就已经在切换到 direct copy 后保留外层 TLS 对象。外层使用 TLS 或 REALITY 均受影响
- JDK 的这个读取循环在 JDK 10 的孵化版 HTTP Client 中就已存在,JDK 11 将它迁入正式的
java.net.http模块 - Loom 从 0.13.1 起改用 JDK HttpClient 下载资源
三者同时具备,最早是在 2022 年 10 月 Xray 1.6.2 发布时。 不使用 Loom、但经 Vision 代理调用 JDK HttpClient 的 Java 程序同样会遇到,文末参考中的几份反馈都属于这种情况
自查与处理
在 daemon 上执行 jcmd <pid> Thread.print -e,如果某个线程的 allocated= 已经达到数百 GB 乃至 TB 级,
并且调用栈停在 SSLFlowDelegate$Reader.unwrapBuffer,基本就是这个问题
处理方式二选一:
- 将 Gradle daemon 所用的 JDK 升级到 11.0.31、17.0.19、21.0.11、25.0.3、26.0.1 或更新版本。
daemon 的 JDK 由
gradle.properties中的org.gradle.java.home、IDE 的 Gradle JVM 设置或 daemon JVM toolchain 决定, 都未指定时沿用启动gradlew的 JDK,即JAVA_HOME。可以用jcmd <pid> VM.version确认 daemon 实际使用的版本 - 使用 Xray Vision 的,将 Xray 服务端升级到 26.9.30 或更新版本
已经陷入循环的 daemon 不会自行恢复,需要 gradlew --stop 或直接结束进程
附:复现程序
下面的程序用 JDK 25 下载上文的资源文件,之后每 5 秒输出一次 JVM 的分配增量,共观察 105 秒。
proxy 经 127.0.0.1:1080 的 HTTP 代理访问,direct 直连。加上 HttpClient 和 TLS 的调试日志后,
可以把分配量突增的时刻与 GOAWAY、close_notify 等关闭事件对应起来
1 | $vmArgs = @( |
1 | // Probe.java |
参考
- Xray issue #6794:Vision direct copy 后外层 TLS 的 close_notify 泄入内层字节流
- Xray PR #6834:修复上述问题
- Xray Vision 的首次提交,随 v1.6.2 发布
- JDK-8374557 的提交: 主线、 11u、 17u、 21u、 25u、 26u
- JDK 10 孵化版 HTTP Client 中最初的
SSLFlowDelegate - Fabric Loom #681:下载器改用 JDK HttpClient,随 0.13.1 发布
- 其他项目中的同类反馈,均为代理或 VPN 环境下 HttpClient 空闲时卡在
SSLFlowDelegate- ED Odyssey Materials Helper #991:堆状态与本文一致
- Skyblocker #2533:Minecraft mod,VLESS 代理环境
- Red Hat 知识库 7141723:JDK 17 下远端关闭连接后 CPU 占满